Агент вместо сценария: как мы описали логику AI-ассистента данными и проверили его на 300 вопросах
Ассистента по базе знаний обычно собирают конвейером «роутер → поиск → ответ», и каждый новый тип вопроса добавляет ветку. В GraphRAG мы заменили конвейер агентом с восемью инструментами, а всё, что должно происходить всегда, вынесли в JSON-харнес с версиями и тестами. Как это устроено, что показало сравнение на 300 вопросах и где агент пока проигрывает.
Коротко. У заказчика уже работал ассистент для покупателей, собранный классически: фильтр, роутер на модели, поиск в нужном разделе, генерация ответа. Он справлялся, пока вопросы укладывались в ветки, и каждый новый тип вопроса требовал новой ветки и нового промпта. В GraphRAG мы пошли другим путём. Агент сам решает, что прочитать в базе и каталоге, а то, что должно происходить всегда, описано в харнесе: это JSON с шагами, промптами и тестами, который меняется без релиза, в том числе внешним ИИ-агентом через MCP. На 300 реальных вопросах покупателей агент ответил лучше прежнего ассистента в 245 случаях. Ниже рассказываем, как это устроено и где агент пока проигрывает.
С чего начали: конвейер, который растёт ветками
Прежний ассистент делал около трёх обращений к модели на ответ и держал в реестре несколько десятков промптов, по набору на ветку. Схема предсказуемая, пока вопрос похож на те, под которые её строили.
Живые вопросы похожи плохо. «А детям можно?» после разговора о товаре, «что есть похожего», сравнение двух позиций, транслит, опечатки, сленг. Под каждый случай нужна своя ветка, и конвейер обрастает исключениями. Когда роутер ошибается, поиск идёт не в тот раздел, и человек получает «ничего не нашлось» там, где ответ в базе есть.
Агент с восемью инструментами
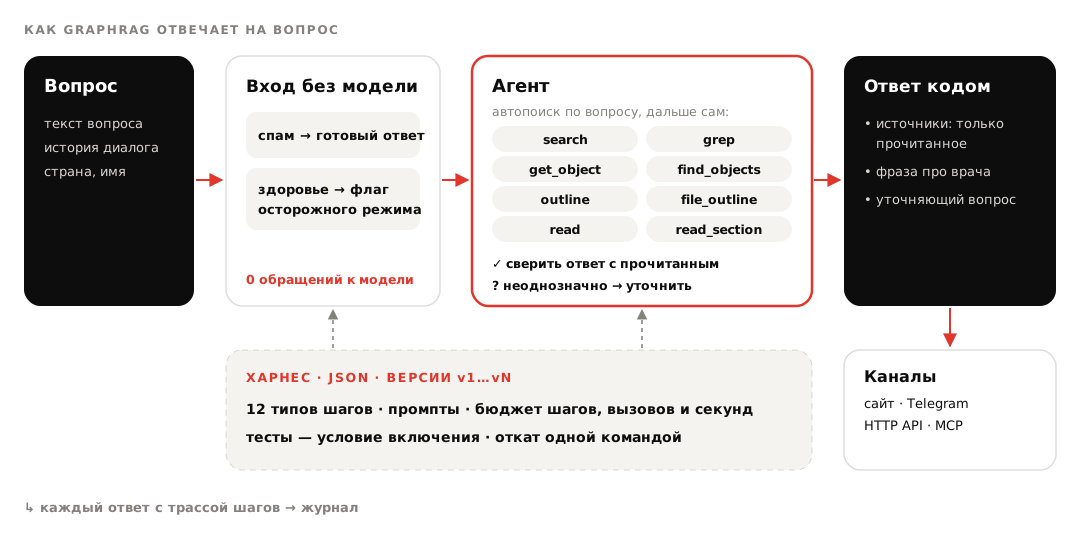
Вместо веток мы дали модели инструменты знания и правила работы:
| Инструмент | Зачем |
|---|---|
search | гибридный поиск по смыслу и по словам, с фильтрами по полям каталога |
grep | дословная строка: артикул, номер пункта, точная формулировка |
get_object, find_objects | карточка товара целиком и выборка каталога по полям |
outline, file_outline | структура базы и оглавление документа |
read, read_section | документ целиком или один его раздел |
Перед первым обращением к модели сервис сам ищет по вопросу и отдаёт найденное агенту. Если ответ уже виден, хватает одного обращения. Если нет, агент дочитывает: открывает раздел, берёт карточку, меняет формулировку. На пустом поиске он меняет способ: смысловой поиск, точная строка, выборка по полям, оглавление базы. Только после этого говорит, что данных нет. Похожую ловушку, когда агент много ищет и мало делает, мы уже разбирали в статье про локальный AI-монтажёр; здесь её закрывает бюджет шагов.
Одно решение мы приняли рано. Источники под ответом собирает программа из того, что агент открыл, модель их не пишет. Первая версия считала источником всё, что агент видел, и под ответом в три строки появлялось сорок ссылок. Теперь поиск по строке и оглавления считаются навигацией, а источником становится только прочитанный документ или карточка товара.
Те же восемь инструментов открыты внешним агентам по MCP. Это одни и те же функции, и отдельный тест следит, чтобы встроенный агент и Claude по MCP видели базу одинаково.
Харнес: логика ответа как данные
Некоторым вещам гибкость агента не нужна. Спам не должен тратить обращение к модели. Фраза «проконсультируйтесь с врачом» в вопросах о здоровье должна быть в ответе всегда, а не когда модель вспомнит. Такие вещи описаны в харнесе. Кода в нём нет: шаги, условия, промпты и тесты, которые исполняет сервис.
{"steps": [
  {"id": "guard", "type": "guard", "rules": [
    {"patterns": ["^\\W*$", "(.)\\1{6,}"], "action": "block", "text": "@replies.spam"},
    {"patterns": ["\\bберемен", "\\bлекарств"], "action": "flag", "set": {"risk": "medium"}}]},
  {"id": "draft", "type": "agent", "final": false, "save_as": "draft"},
  {"id": "risky", "type": "check", "if": {"var": "risk", "eq": "medium"},
   "then": "with_disclaimer", "else": "plain"},
  {"id": "with_disclaimer", "type": "answer", "text": ["{{draft.answer}}", "@disclaimer"]},
  {"id": "plain", "type": "answer", "text": "{{draft.answer}}"}
]}
Здесь бессмыслица отсекается регулярным выражением без модели, вопрос про беременность или лекарства получает пометку, агент пишет черновик, а обязательную фразу приклеивает код. Всего типов шагов двенадцать: проверки, ветвления, переменные, поиск в нужном разделе, свои LLM-шаги с ответом по JSON-схеме, агент со своим набором инструментов, готовый ответ.
Харнес проверяется до сохранения: неизвестное поле, битый переход или ссылка на несуществующий промпт не дадут сохранить версию. У версии есть бюджет по шагам, обращениям к модели и секундам. Если активная версия всё-таки сломалась, коллекция отвечает встроенным харнесом и пишет предупреждение в ответ. Блок-схема в админке рисуется из того же JSON без модели, поэтому схема и реальная логика не расходятся.
Почему встроенный харнес такой простой
Встроенный харнес у сервиса один, и это одно прохождение агента с тремя правилами. Поиск не помог: посмотреть структуру базы. Перед ответом: сверить каждое число, срок и условие с прочитанным. Вопрос можно понять по-разному, и от этого зависит ответ: вернуть уточняющий вопрос с вариантами.
Мы пробовали добавить отдельный шаг проверки черновика на выдумки. На наборе из 65 вопросов по HR-базе качество осталось тем же, 64 верных ответа, а обращений к модели и времени стало вдвое больше. Сверка правилом в промпте дала тот же результат за 3,8 секунды. Для сравнения, схема «поиск + ответ моделью» на этом наборе даёт 60 верных и 7 выдумок, агент 64 и 3. Коллекция, которой точность важнее скорости, может собрать проверку черновика в своём харнесе.
Как харнес улучшают через MCP
У коллекции две ссылки MCP. Пользовательская даёт 11 инструментов для поиска и ответа, админская ещё 35: харнес, журнал ответов, документы, категории, настройки, архивы. Если у коллекции включён модуль «Клиенты», на админской ссылке появляется ещё 31 инструмент: услуги, расписание, сценарии. Про него у нас отдельная статья. По админской ссылке внешний ИИ-агент проходит цикл улучшения сам.
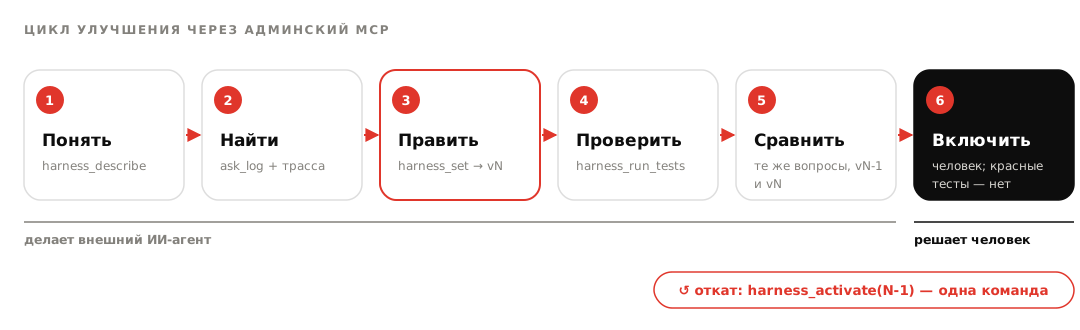
Тест харнеса состоит из вопроса и ожиданий: какие шаги пройдены, какие фразы есть в ответе, какие инструменты вызваны, сколько было обращений к модели. Версию с красными тестами MCP не включит, пока её явно не включат с force. Включает версию человек, этот шаг мы сознательно оставили владельцу коллекции. Откат на прошлую версию делается одной командой.
У пилотного ассистента так набралось десять версий. Первая перенесла логику прежнего конвейера, дальше добавлялись проверка спама без модели, осторожный режим, страна пользователя, правило про контекст диалога. Девятую, с подбором похожих товаров через категорию, предложил и проверил тестом внешний агент по админской ссылке. Ни одна из этих правок не потребовала релиза сервиса.
Как сделать логику изменяемой и не сломать её
Харнес полезен, только пока правку можно проверить до включения и откатить после. За несколько недель работы мы пришли к набору решений. Они не привязаны к GraphRAG, и их можно взять в любую систему, где логику ассистента правят без релиза.
| Решение | Что даёт |
|---|---|
Встроенный агент тоже харнес, из одного шага agent | одна машина исполнения: у своей версии и у встроенной общие тесты, трасса и бюджеты |
Валидатор до сохранения и справка по формату (harness_schema) | агент-редактор получает формат с примерами и ошибку сразу, а не сломанную коллекцию |
harness_set возвращает список изменений | видно, что именно поменяла правка, ещё до прогона тестов |
| Название, описание и слой у каждого шага | человек читает схему во вкладке «Харнес», агент понимает, зачем шаг нужен |
| Тесты лежат внутри версии | откат возвращает и логику, и проверки к ней |
| Бюджет версии: по умолчанию 20 шагов, 10 обращений к модели, 120 секунд | ошибка в переходах не превращается в бесконечный цикл за счёт владельца |
| Сломанная активная версия не роняет ответ | коллекция отвечает встроенным харнесом и пишет предупреждение в ответ |
Тест проверяет восемь видов ожиданий: пройденные и непройденные шаги, фразы в ответе и их отсутствие, регулярное выражение, предел обращений к модели, число источников и вызванные инструменты. Последнее мы добавили под правило «похожие товары ищи через категорию»: проверка tools_contains: find_objects смотрит, вызвал ли агент нужный инструмент, а не только что он написал в ответе.
Отдельный вопрос: как расширять систему, не правя каждую кастомную версию. Мы договорились, что модули дописывают свои правила к любому харнесу сами. Когда у коллекции включён модуль «Клиенты», код модуля добавляет к системному промпту агента абзац о клиенте и правила записи, а к инструментам агента добавляет инструменты карточки и расписания. Поэтому харнес демо-салона получил кнопки выбора без новой версии, и мы проверили это вживую. Если коллекции нужна своя логика, данные доступны шагам как переменные {{client.*}} и {{user.*}}.
Мелкие правки поведения тоже живут в версии. В шаблонах ответа есть фильтры: trim, lower, strip_prefix, capfirst, default, truncate. Однажды после отрезанного маркера «УТОЧНЕНИЕ:» модель продолжала вопрос с маленькой буквы. Фильтр capfirst пришлось добавить в код, а применили его уже правкой версии харнеса, одной строкой. Ответ на вопрос не по теме тоже не зашит в промпт: это настройка коллекции, и встроенный харнес отвечает ею, а не рассуждает о посторонних задачах.
Что показало сравнение на 300 вопросах
Мы прогнали 300 вопросов покупателей из 27 категорий через обе системы: прежний ассистент заказчика и агента на харнесе. Ответы оценивал LLM-судья вслепую: он не знал, где какая система, порядок ответов чередовался. Пять критериев от 1 до 5 и общий вердикт.
| Агент на харнесе | Прежний конвейер | |
|---|---|---|
| Победы из 300 (ничьих 18) | 245 | 37 |
| Средний балл из 5 | 4,55 | 3,63 |
| Честность / достоверность | 4,57 / 4,48 | 3,53 / 3,52 |
| Обращений к модели на ответ | 1,74 | 2,53 |
| Время ответа, в среднем | 7,9 с | 4,2 с |
Больше всего агент выиграл там, где конвейер ломался на ветках: вопросы-продолжения диалога (55 из 65), факты о товарах и подбор (77 из 84), вопросы о здоровье (31 из 31). Прежний ассистент сильнее в справочном: контакты офисов, расписание мероприятий. Там его ответы полнее, у агента верные, но короче.
Честные ограничения
- Агент медленнее. В среднем 7,9 секунды против 4,2, потому что он читает источник перед ответом. Для простых справочных вопросов это лишнее, и следующий кандидат в харнес у нас короткая ветка «поиск → ответ» без агента.
- Проверки без модели пропускают. Словарь спама ловит рекламу, но не бессмыслицу вроде «ааааа». Медицинский маркер сработал на 7 вопросах из 50, где нужен осторожный режим. Остальные агент провёл по правилам промпта и выиграл всю категорию, но гарантия кодом сработала только на семи.
- Иногда путает контекст. В нескольких цепочках агент ответил про другой товар из истории диалога или выбрал соседний раздел базы.
- Судья шумит. Повторные оценки того же LLM-судьи совпадают примерно в 92% случаев, поэтому решения мы принимаем по устойчивым сдвигам, а разницу в два-три вопроса считаем шумом.
- Цикл не замкнут до конца. Внешний агент правит и тестирует харнес сам, но включает версию человек.
- Тесты харнеса идут без клиента. Инструменты карточки клиента в них недоступны, поэтому запись от имени клиента тестом не проверить; свободное время доступно.
FAQ
Чем харнес отличается от промпта? Промпт задаёт, как модель рассуждает внутри одного шага. Харнес задаёт, какие шаги будут, что выполняется без модели, какие инструменты доступны агенту и что проверяют тесты. Промпты лежат внутри версии харнеса, поэтому откат возвращает и логику, и тексты.
Можно ли перенести наш существующий конвейер? Да. Классический сценарий «фильтр → роутер → поиск по разделу → ответ» описывается харнесом один в один, на это есть тест. Дальше его можно упрощать и сравнивать версии на одних и тех же вопросах.
Какая модель нужна? Любая с вызовом функций через OpenAI-совместимый API. В пилоте отвечала gpt-5.6-luna, эмбеддинги считала text-embedding-3-small. Рассуждающая модель на тех же вопросах работала в два-четыре раза медленнее, и мы от неё отказались.
Где хранятся данные? GraphRAG работает как SaaS или ставится одним сервисом в Docker в контуре компании. У каждого клиента или отдела своя изолированная коллекция: документы, индекс, история, харнес и ссылки MCP. Подробнее на странице продукта.